تولید بردار نویسنده: تشخیص هویت و شخصیت نویسنده
این اسناد، جزئیات یک اختراع ثبتشدهی گوگل پتنت را توضیح میدهند که حول محور سیستمهای مبتنی بر شبکه عصبی برای تحلیل متن و ساخت بردار نویسنده شکل گرفته است. ایدهی اصلی این فناوری این است که با استفاده از یادگیری ماشین، ویژگیهای آماری و سبکی نوشتههای هر فرد را استخراج کند و آنها را در قالب مجموعهای از مختصات عددی (بردار) نگه دارد؛ مختصاتی که میتوانند ابعادی مثل شخصیت، سبک ارتباطی و الگوهای کلامی نویسنده را مدلسازی کنند.
نکته: این روش نیازی به برچسبگذاری دستی متن ها ندارد (Self-Supervised)؛ یعنی سیستم میتواند بدون دخالت انسانی، متن ها را طبقهبندی کند و همین موضوع باعث میشود کارایی سیستمهای پردازش زبان طبیعی به شکل قابلتوجهی افزایش پیدا کند.
چکیده
این پتنت روشی را توضیح میدهد که با استفاده از آن میتوان «بردار نویسنده» (Author Vector) تولید کرد؛ یعنی یک بازنمایی عددی که مشخصات سبک نوشتاری هر نویسنده را در خودش نگه میدارد. روش کار اینطور است: یک مجموعه از دنبالههای کلمات جمعآوری میشود که شامل چند «دنباله اول» است و برای هر دنباله اول، یک «دنباله دوم» هم وجود دارد که بعد از آن دنباله اول میآید. مهم است بدانید که همهی این دنبالهها (هم اول و هم دوم) از قبل مشخص شده که نوشتهی یک نویسنده خاص هستند. سپس یک شبکه عصبی روی این دنبالهها آموزش داده میشود تا بردار نویسنده را برای آن نویسنده مشخص محاسبه کند؛ بردار نویسندهای که در واقع، ویژگیهای خاص نوشتاری آن فرد را نشان میدهد.
کاربردها
تأیید اصالت و هویت نویسنده
این سیستم میتواند بررسی کند که آیا یک متن جدید واقعا توسط یک نویسنده مشخص نوشته شده است یا خیر.
روش کار: سیستم ابتدا متن جدید را تحلیل کرده و بردار لحن آن را محاسبه میکند. سپس این بردار را با بردار مرجع آن نویسنده خاص مقایسه میکند. اگر فاصله ریاضی میان این دو بردار از یک حد آستانه کمتر باشد، سیستم تأیید میکند که متن متعلق به همان شخص است. این ویژگی در امنیت سایبری و کشف جعل هویت کاربرد حیاتی دارد.
شناسایی و کشف نویسنده ناشناس
اگر متنی بدون نام نویسنده داشته باشید، سیستم میتواند هویت واقعی خالق اثر را در میان مجموعهای از نویسندگان کشف کند.
روش کار: سیستم بردار سبک نگارش متن ناشناس را استخراج کرده و آن را با بانک بردارهای نویسندگان موجود مقایسه میکند. در نهایت، متنی که بردار آن بیشترین شباهت و کمترین فاصله ریاضی را با یکی از بردارها داشته باشد، به عنوان نویسنده اثر معرفی میشود. این قابلیت برای تحقیقات ادبی، بررسیهای حقوقی و قضایی بسیار ارزشمند است.
یافتن نویسندگان همسبک و مشابه
سیستم قادر است با مقایسه بردارهای ریاضی، نویسندگانی را که شیوه بیان، لحن، دایره واژگان و عادتهای ارتباطی مشابهی دارند شناسایی کند. این ویژگی به کاربران کمک میکند تا نویسندگان جدیدی را کشف کنند که سبک نگارش آنها با سلیقه ادبیشان همخوانی دارد.
شخصیسازی لحن چتباتها و دستیارهای صوتی
روش کار: سیستم میتواند کاربران را بر اساس عادات نگارشیشان خوشهبندی (Clustering) کند. سپس چتبات یا دستیار هوشمند، لحن پاسخدهی خود را بر اساس بردار نمایندهی آن خوشه تنظیم میکند تا بسیار طبیعیتر، همسطح و همدلانه با کاربر گفتگو کند. حتی میتوان سیستم را به گونهای تنظیم کرد که پاسخها را در قالب لحن یک نویسنده مشهور (مانند یک بردار نویسنده خاص) تولید کند.
پیشبینی تیپهای شخصیتی
گوگل با این پتنت میتواند صرفا از روی نوشتههای شما، به شخصیت درونیتان پی ببرد.
روش کار: سیستم ابتدا بردارهای نویسندگان را خوشهبندی میکند. سپس با تلفیق این خوشهها و نتایج تستهای شخصیتی استاندارد (مانند مایرز-بریگز (MBTI) یا تیپهای پنج عامل بزرگ شخصیت (OCEAN))، یک مدل یادگیری ماشین (مانند رگرسیون لجستیک) را آموزش میدهد تا ارتباط بین سبک نگارش و تیپ شخصیتی را یاد بگیرد. در نهایت با دریافت بردار یک نویسنده جدید، تیپ شخصیتی او با دقت بالا پیشبینی میشود.
منبع این مقاله : US11868724B2
بخش اول: سیستم پایه
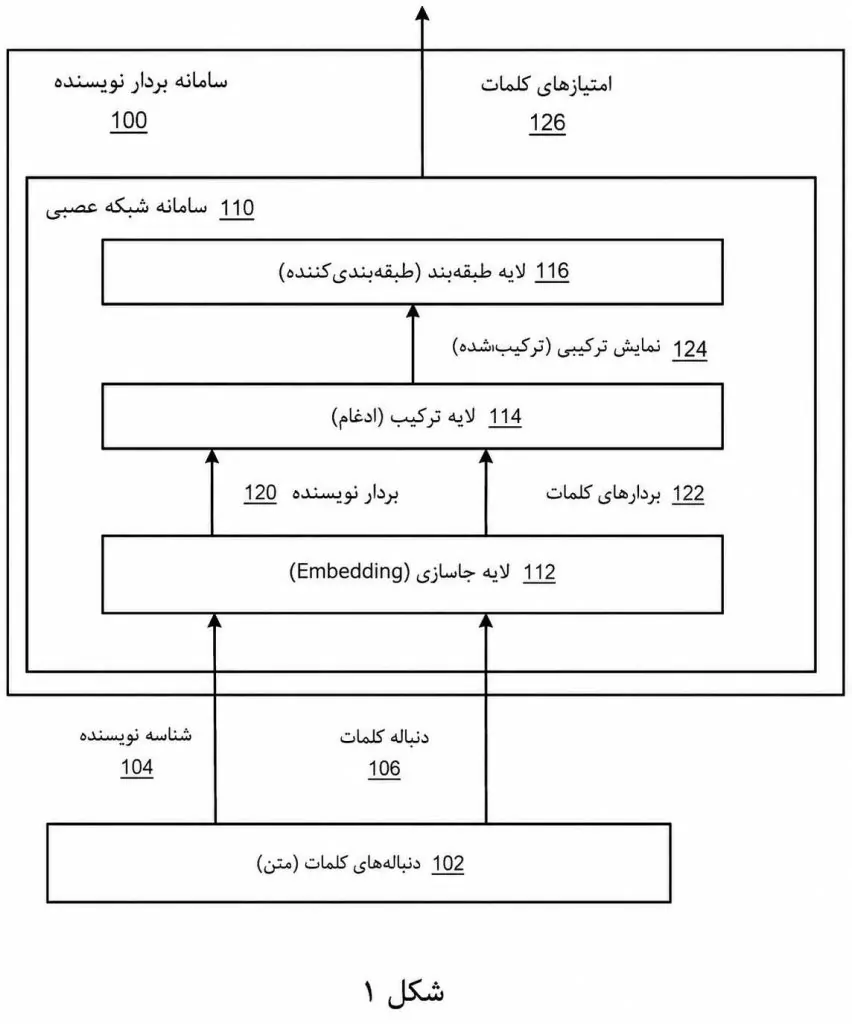
شکل ۱ نمودار بلوکی یکی از دو معماری اصلی پتنت گوگل «Generating Author Vectors» است: سیستم بردار نویسنده ۱۰۰. این سیستم یک شبکه عصبی است که با گرفتن یک دنباله از کلمات (مثلا یک جمله) و شناسه نویسنده آن، دو خروجی تولید میکند:
- امتیاز کلمات (Word Scores): برای هر کلمه در واژگان از پیش تعیینشده، احتمال اینکه آن کلمه بعد از آخرین کلمهی دنباله بیاید.
- بردار نویسنده (Author Vector): یک مجموعه عدد اعشاری که سبک نوشتاری، لحن ارتباطی یا حتی نوع شخصیت نویسنده را کدگذاری میکند.
هدف نهایی سیستم این است که با آموزش روی متنهای چند نویسنده، یاد بگیرد چگونه «هویت نوشتاری» هر فرد را از دل متن او استخراج کند.
بخش ورودیها (Inputs)
مجموعه توالیهای متنی (Set of Word Sequences – 102): بانک اطلاعاتی شامل متن ها مختلفی است که میدانیم همگی توسط یک نویسنده خاص نوشته شدهاند.
شناسه نویسنده (Author Identifier – 104): یک آیدی اختصاصی و منحصربهفرد (مانند یک کد کاربری) است که سیستم به هر نویسنده نسبت میدهد تا مدل بتواند نوشتههای او را از دیگران تفکیک کند.
توالی کلمات ورودی (Word Sequence – 106): بخشی از متن نویسنده (مانند یک جمله نیمهکاره) که به عنوان ورودی اولیه برای پردازش انتخاب شده و به مدل ارسال میشود.
شبکه عصبی پردازشگر ( 110)
این بخش قلب تپنده هوش مصنوعی است که متنها و شناسهها را به ریاضیات تبدیل و ترکیب میکند:
لایه جاسازی (Embedding Layer – 112): این لایه کار ترجمه متن به زبان ماشین را انجام میدهد.
بردار نویسنده (Author Vector – 120): شناسه نویسنده (104) را میگیرد و آن را به یک بردار عددی (لیستی از اعداد اعشاری) تبدیل میکند که نماینده سبک شخصی و لحن نگارش اوست.
بردار نمایش کلمات (Word Vector Representations – 122): تکتک کلمات جمله ورودی (106) را به بردارهای عددی مجزا تبدیل میکند تا معنای لغوی کلمات برای کامپیوتر ملموس شود.
لایه ادغامکننده (Combining Layer – 114):
نمایش ترکیبی (Combined Representation – 124): این لایه بردار لحن نویسنده (120) و بردارهای معنایی کلمات (122) را با یکدیگر ترکیب کرده و یک خروجی واحد میسازد. این ترکیب معمولا از طریق چسباندن بردارها به هم (Concatenate)، میانگینگیری (Average) یا جمع ریاضی آنها (Sum) انجام میشود. با این کار، اطلاعات سبک نویسنده مستقیما به بافتار کلمات تزریق میشود.
لایه طبقهبندیکننده (Classifier Layer – 116): این لایه خروجی ادغامشده (124) را دریافت کرده و با استفاده از پارامترهای خود، احتمال آمدن تکتک کلمات زبان را در جایگاه بعدی جمله محاسبه میکند.
بخش خروجی (Output)
امتیاز کلمات (Word Scores – 126): خروجی نهایی سیستم، لیستی از امتیازها برای کلمات مختلف است. کلمهای که بالاترین امتیاز احتمالی را متناسب با سبک نگارشی آن نویسنده خاص کسب کند، به عنوان پیشبینی کلمه بعدی ارائه میشود.
فرآیند عملکردی سیستم
- ابتدا سیستم یک جمله (مثلا: “امروز هوا بسیار…”) و شناسه کاربر (مثلا: نویسنده مینیمالیست) را به عنوان ورودی میگیرد.
- لایه جاسازی (112) کلمات جمله را به بردارهای معنایی و شناسه کاربر را به بردار سبک (لحن کوتاهنویسی و سادهگویی) تبدیل میکند.
- لایه ادغام (114) این دو بردار را با هم ترکیب میکند تا یک مفهوم “جمله + لحن نویسنده” ساخته شود.
- لایه طبقهبندی (116) این معجون را تحلیل کرده و به جای واژههای پیچیده، کلمات سادهتر مانند “خوب است” را با امتیاز بالا به عنوان خروجی (126) پیشنهاد میدهد.
- در زمان برخورد با یک نویسنده جدید، سیستم تمام بردارهای کلمات و تنظیمات شبکه را ثابت (Fixed) نگه میدارد و با استفاده از خطا در حدسها، فقط و فقط بردار نویسنده (120) را با الگوریتم گرادیان کاهشی بهینهسازی میکند تا سبک نگارشی او با بالاترین دقت کشف شود
بخش دوم: سیستم پیشرفته مبتنی بر LSTM
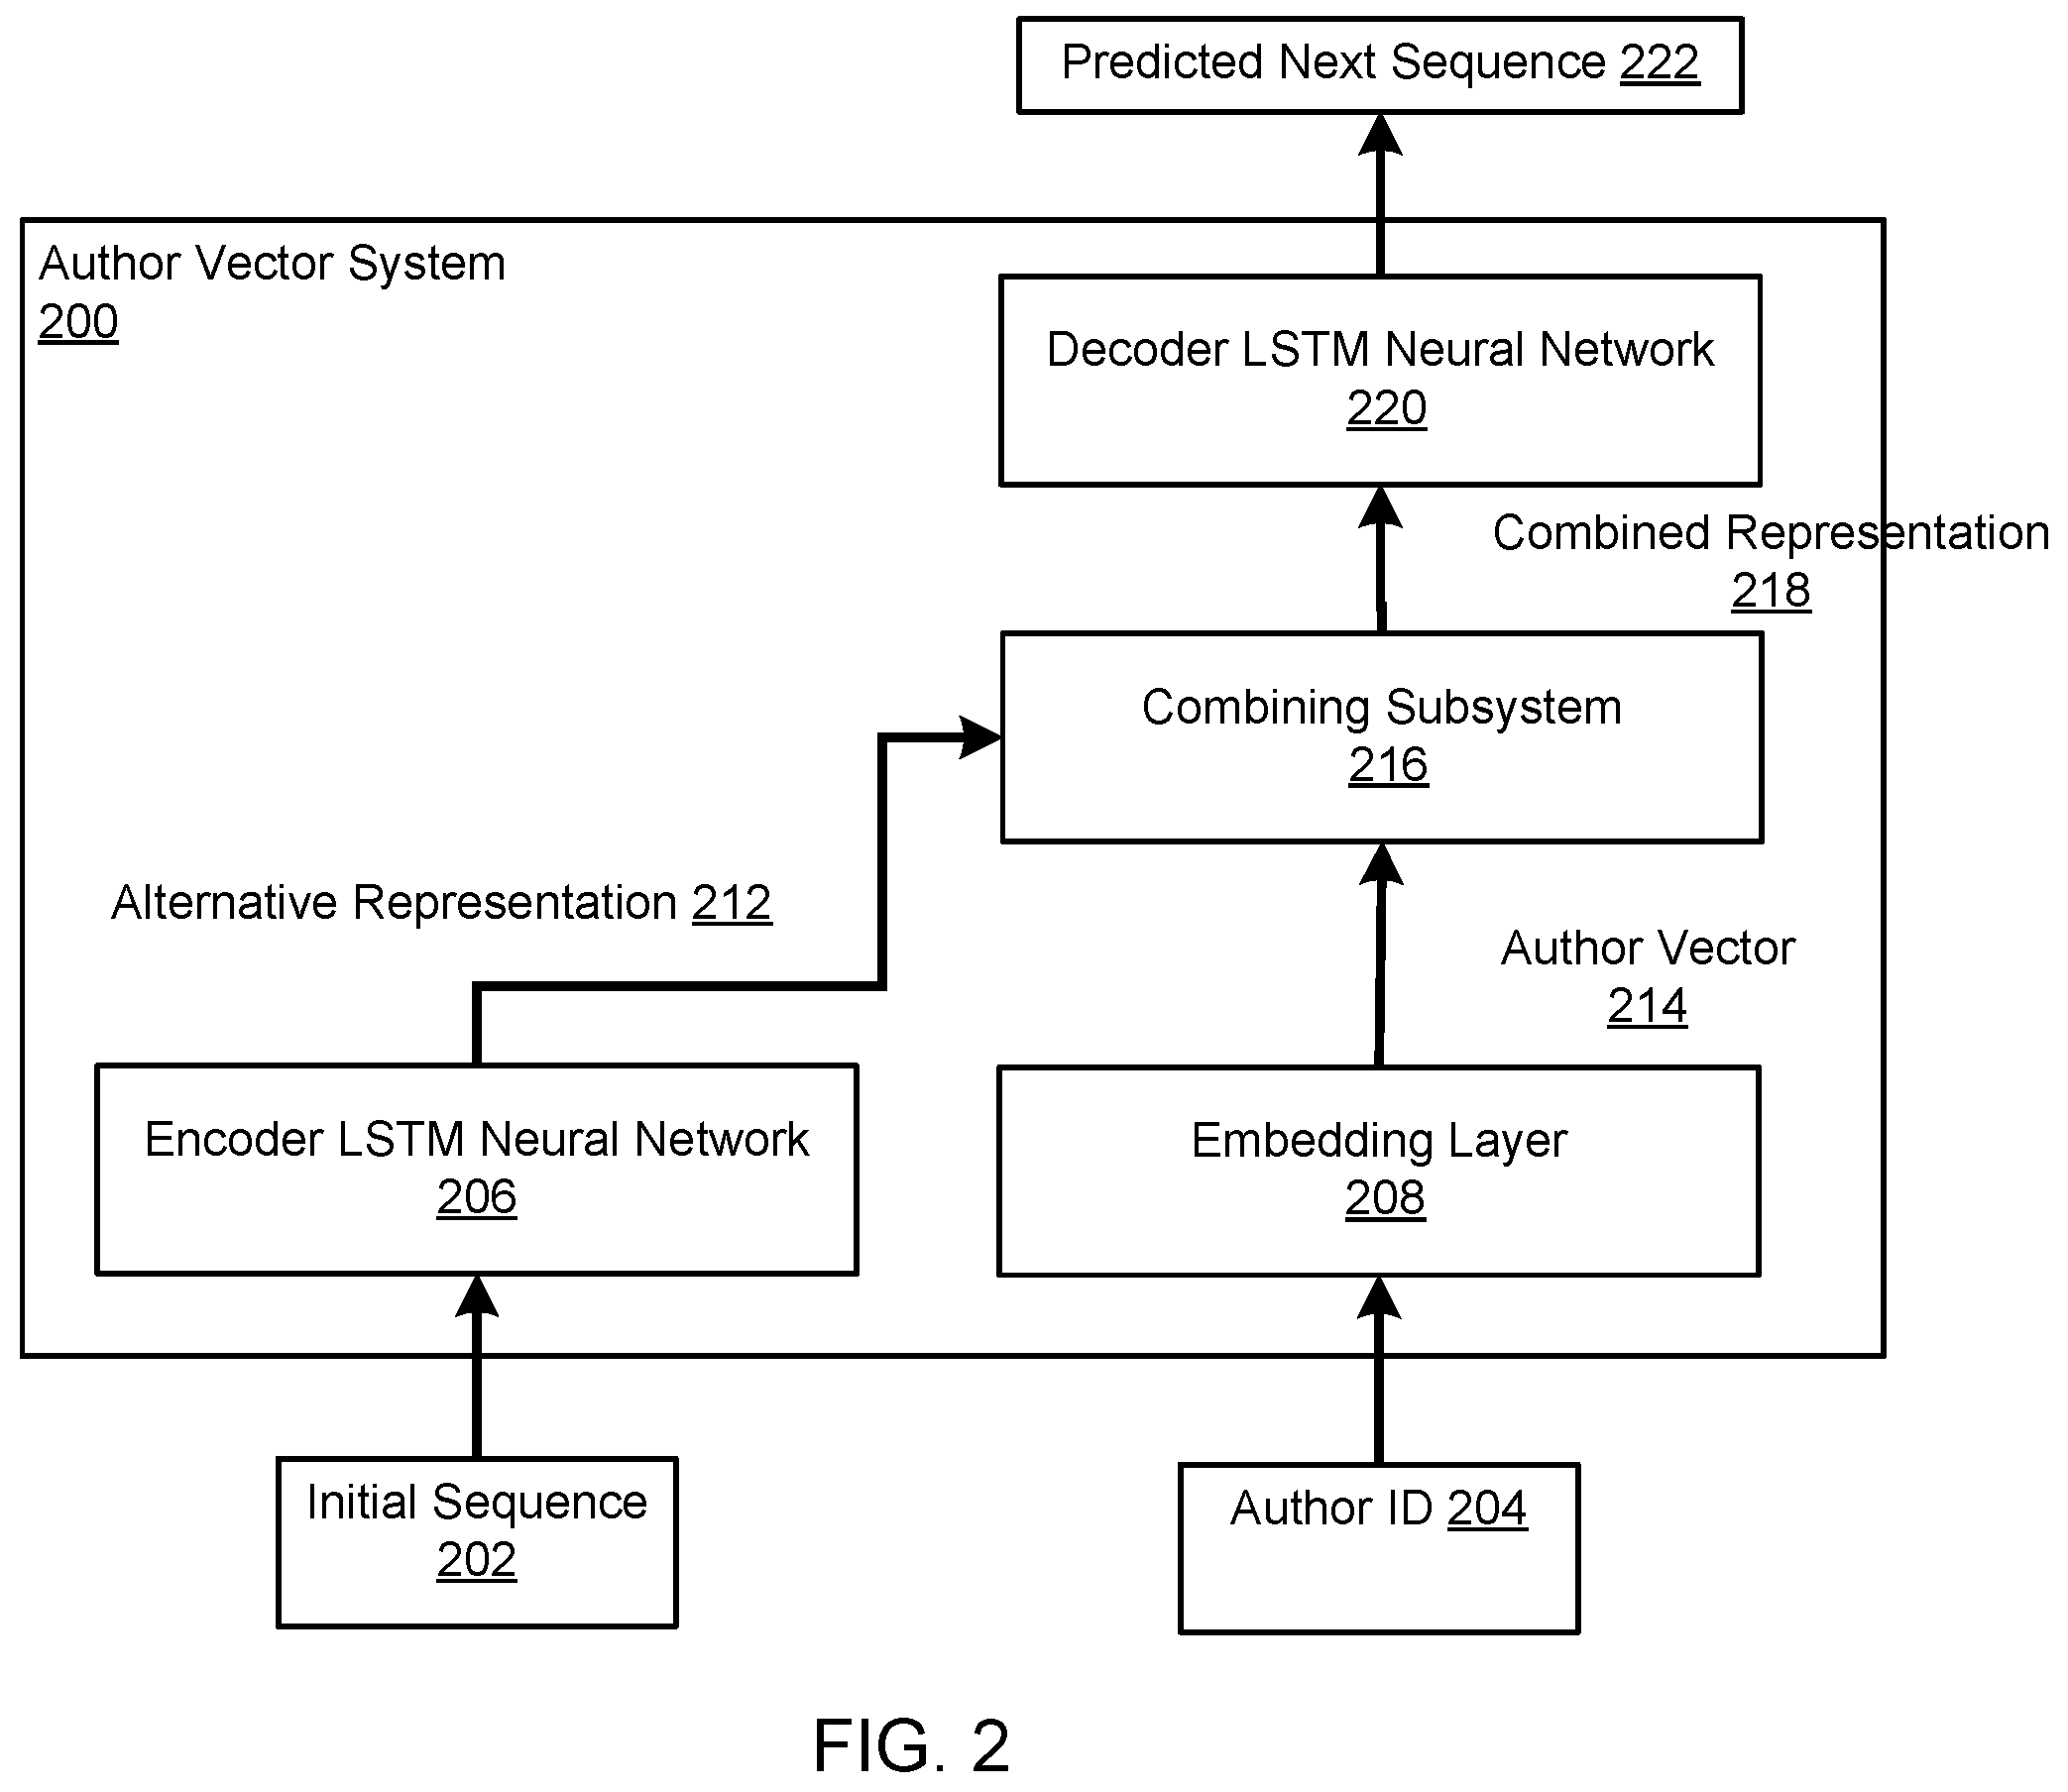
شکل ۲ (FIG. 2) معماری پیشرفتهتر گوگل را نشان میدهد که بر پایه مدل توالی به توالی (Sequence-to-Sequence یا به Seq2Seq) طراحی شده است. برخلاف معماری شکل ۱ که صرفا کلمه بعدی را پیشبینی میکرد، این سیستم برای پیشبینی و تولید یک جمله یا عبارت کامل با طول متغیر به عنوان ادامه نوشته قبلی کاربرد دارد.
این معماری از دو بخش اصلی شبکههای عصبی حافظه کوتاهمدت ماندگار (LSTM) شامل یک رمزگذار (Encoder) و یک رمزگشا (Decoder) استفاده میکند. هدف نهایی سیستم این است که ایده و مفهوم جمله اول را دریافت کند، آن را با لحن شخصی و منحصربهفرد نویسنده مخلوط کند و سپس ادامهی متن را دقیقا با همان سبک و سیاق به نگارش درآورد.
ورودیهای سیستم (Inputs)
توالی اولیه (Initial Sequence – 202): جمله یا عبارت ورودی است که نویسنده نوشته و قرار است سیستم ادامه آن را تولید کند. طول این جمله میتواند متغیر باشد.
شناسه نویسنده (Author Identifier – 204): یک شناسه یکتا است که مشخص میکند نویسنده این متن چه کسی است تا سیستم سبک نگارشی او را فراخوانی کند.
مرحله رمزگذاری و استخراج لحن (Encoding & Vector Mapping)
شبکه عصبی رمزگذار الاستیام (Encoder LSTM – 206): این شبکه عصبی بازگشتی (Recurrent Neural Network)، کلمات جمله ورودی را یکییکی و به ترتیب ورود پردازش کرده و حالت داخلی (Hidden State) خود را در هر گام بهروزرسانی میکند.
نمایش جایگزین (Alternative Representation – 212): پس از اینکه رمزگذار آخرین کلمه جمله ورودی را خواند، حالت داخلی نهایی خود را به عنوان یک بردار عددی فشرده خارج میکند. این بردار دارای طول ثابت است و چکیده معنایی کل جمله را بدون وابستگی به طول جمله ورودی در خود حفظ میکند.
لایه جاسازی (Embedding Layer – 208): همزمان با کار رمزگذار، این لایه شناسه نویسنده (204) را دریافت کرده و بر اساس پارامترهای خود، آن را به یک بردار نویسنده (Author Vector – 214) تبدیل میکند که امضای لحنی و ادبی نویسنده را در قالب اعداد اعشاری نمایش میدهد.
مرحله تلفیق و ادغام (Combining Phase)
زیرسیستم ادغامکننده (Combining Subsystem – 216): این بخش وظیفه دارد خلاصه معنایی جمله ورودی (212) را با بردار لحن و امضای نویسنده (214) تلفیق کند.
نمایش ترکیبی (Combined Representation – 218): خروجی این زیرسیستم یک بردار واحد است که هم حاوی مفهوم آنچه نوشته شده و هم حاوی شخصیت و سبک فرد نگارنده است. این کار با چسباندن بردارها به هم (Concatenation)، میانگینگیری (Averaging) یا جمع ریاضی آنها انجام میشود.
مرحله رمزگشایی و تولید خروجی (Decoding & Output Generation)
(Decoder LSTM – 220): این شبکه با استفاده از بردار ترکیبی (218) به عنوان وضعیت اولیه، کار خود را شروع میکند. این مدل کلمه به کلمه شروع به حدس و تولید متن بعدی میکند و در هر مرحله حالت داخلی خود را با کلمه تولیدشده قبلی بهروزرسانی میکند تا انسجام جمله حفظ شود.
توالی بعدی پیشبینیشده (Predicted Next Sequence – 222): خروجی نهایی سیستم که یک جمله جدید با طول متغیر است و به عنوان پاسخ یا ادامه منطقی متن اول، کاملا منطبق بر سبک نگارشی نویسنده تولید شده است.
فرآیند عملکردی سیستم همراه با مثال
فرض کنید دو نویسنده وبلاگ با دو سبک و مخاطب کاملا متفاوت در یک پلتفرم وبلاگنویسی بزرگ (مانند ویرگول یا مدیوم) فعالیت میکنند:
۱. بابک (نویسنده وبلاگ تخصصی فناوری): سبک او تحلیلگرایانه، علمی، پر از آمار و ارقام و اصطلاحات سخت افزاری است. مخاطبان او مهندسان و شیفتگان تکنولوژی هستند.
۲. سارا (نویسنده وبلاگ سبک زندگی و موفقیت): سبک او داستانی، انگیزشی، صمیمی، ساده و همدلانه است. مخاطبان او عموم مردم هستند که به دنبال داستانهای الهامبخش میگردند.
هر دو نویسنده پست جدید خود را با این جمله شروع میکنند: «هوش مصنوعی در سالهای آینده…». سیستم گوگل چگونه ادامه این پاراگراف را برای هر کدام از آنها پیشبینی و تولید میکند؟ فرآیند را گامبهگام دنبال کنیم:
گام اول: شروع نوشتن و ورود به سیستم (شکل ۲ – بخشهای ۲۰۲ و ۲۰۴)
سناریوی بابک:
بابک در پنل کاربری خود جمله اولیه را تایپ میکند: «هوش مصنوعی در سالهای آینده» که همان توالی اولیه (Initial Sequence – 202) است.
سیستم شناسه کاربری او را در پسزمینه فرامیخواند: Author Identifier = 204_Babak (شناسه نویسنده – 204).
گام دوم: تفکیک ایده از قلم نویسنده (بخشهای ۲۰۶، ۲۰۸، ۲۱۲ و ۲۱۴)
در این مرحله، هوش مصنوعی معنای نوشته را از سبک نگارشی نویسنده جدا میکند تا بتواند آنها را به طور مستقل پردازش کند:
۱. درک معنای جمله توسط رمزگذار (Encoder LSTM – 206):
شبکه عصبی رمزگذار LSTM کلمات جمله «هوش»، «مصنوعی»، «در»، «سالهای»، «آینده» را به ترتیب میخواند. کار این شبکه فقط فهمیدن موضوع کلی است.
خروجی آن یک بردار فشرده ریاضی به نام نمایش جایگزین (Alternative Representation – 212) است که مفهوم خام جمله را در خود دارد: «پیشبینی وضعیت فناوری در آینده».
۲. استخراج قلم و امضای ادبی بابک (Embedding Layer – 208):
شناسه بابک وارد لایه جاسازی شده و تبدیل به بردار نویسنده (Author Vector – 214) میشود. این بردار عددی، ویژگیهای پنهان قلم بابک را فرموله کرده است:
بردار قلم بابک: [0.98, -0.90, 0.88] (دادهمحور بودن بالا = ۰.۹۸، استفاده از تمثیل و احساسات پایین = ۰.۹۰-، رسمیت علمی بالا = ۰.۸۸).
گام سوم: ترکیب ایده و قلم در کارگاه ادغام (Combining Subsystem – 216)
زیرسیستم ادغامکننده (216) بردار مفهوم خام جمله یعنی «پیشبینی وضعیت فناوری در آینده» را با بردار قلم بابک یعنی «علمی، رسمی و دادهمحور» ترکیب میکند.
خروجی این بخش، نمایش ترکیبی (Combined Representation – 218) است. این بردار جدید در واقع یک نقشه راه به رمزگشای سیستم میدهد: «یک جمله با موضوع آینده فناوری بنویس، اما حتما از اصطلاحات تخصصی و لحنی جدی استفاده کن».
گام چهارم: تحریر جمله بعدی وبلاگ (Decoder LSTM – 220)
رمزگشا LSTM (220) با داشتن این دستورالعمل ریاضی دقیق، کلمه به کلمه جمله بعدی را به عنوان ادامهی پاراگراف تولید میکند:
کلمه اول: «نیازمند»
کلمه دوم: «زیرساختهای»
کلمه سوم: «پردازشی»
کلمه چهارم: «تنسور»
کلمه پنجم: «و»
کلمه ششم: «الگوهای»
کلمه هفتم: «ترنسفورمر»
کلمه هشتم: «است.»
خروجی نهایی پیشبینیشده برای وبلاگ بابک (Predicted Next Sequence – 222): «نیازمند زیرساختهای پردازشی تنسور و الگوهای ترنسفورمر است.»
حالا همین فرآیند برای وبلاگ سارا (نویسنده سبک زندگی)
اگر سارا با شناسه 204_Sara دقیقا همان جمله اولیه یعنی «هوش مصنوعی در سالهای آینده» را در وبلاگش بنویسد:
۱. رمزگذار LSTM (206) مجددا همان بردار مفهوم خام یعنی «پیشبینی وضعیت فناوری در آینده» را تحویل میدهد. ۲. لایه جاسازی (208) بردار قلم سارا را استخراج میکند:
بردار قلم سارا: [-0.15, 0.92, -0.30] (فناوری و ریاضیات خشک پایین، صمیمیت و الهامبخشی بالا، رسمیت علمی کم). ۳. زیرسیستم ادغام (216) این دو بردار را ترکیب میکند تا دستورالعمل جدیدی ساخته شود: «یک جمله با موضوع آینده فناوری بنویس، اما لحنی صمیمی، امیدبخش و داستانی داشته باشد». ۴. رمزگشا LSTM (220) با این الگو شروع به نوشتن میکند:
کلمه اول: «به»
کلمه دوم: «ما»
کلمه سوم: «کمک»
کلمه چهارم: «میکند»
کلمه پنجم: «تا»
کلمه ششم: «رویاهایمان»
کلمه هفتم: «را»
کلمه هشتم : «آسانتر»
کلمه نهم: «بسازیم.» ۵. خروجی نهایی پیشبینیشده برای وبلاگ سارا: «به ما کمک میکند تا رویاهایمان را آسانتر بسازیم.»
گام پنجم: کالیبره شدن سریع سیستم برای یک نویسنده وبلاگ جدید (شکل ۸)
فرض کنید یک وبلاگنویس جدید به نام «نوید» (که سبک او طنزآمیز و منتقدانه است) عضو پلتفرم میشود:
نوید شروع به نوشتن اولین پست خود میکند.
سیستم تلاش میکند بر اساس حدسهای کلی، جمله بعدی او را بنویسد اما خطا میدهد؛ چون طنزنویسی نوید را نمیشناسد.
مزیت شگفتانگیز این پتنت: هوش مصنوعی گوگل برای یادگیری لحن نوید، کل معماری سنگین سیستم یعنی رمزگذار (206)، بخش ادغام (216) و رمزگشا (220) را کاملا ثابت و قفل (Fixed) نگه میدارد.
با کمک الگوریتم ریاضی گرادیان کاهشی (Gradient Descent – 812)، خطا بررسی شده و سیستم فقط بردار نویسنده نوید (214) را در لایه جاسازی تغییر میدهد تا نمک طنز و نقد به آن اضافه شود. پس از نوشتن تنها چند پاراگراف، بردار نوید کالیبره شده و سیستم یاد میگیرد برای او جملاتی با لحن طنز و نیشدار تولید کند!
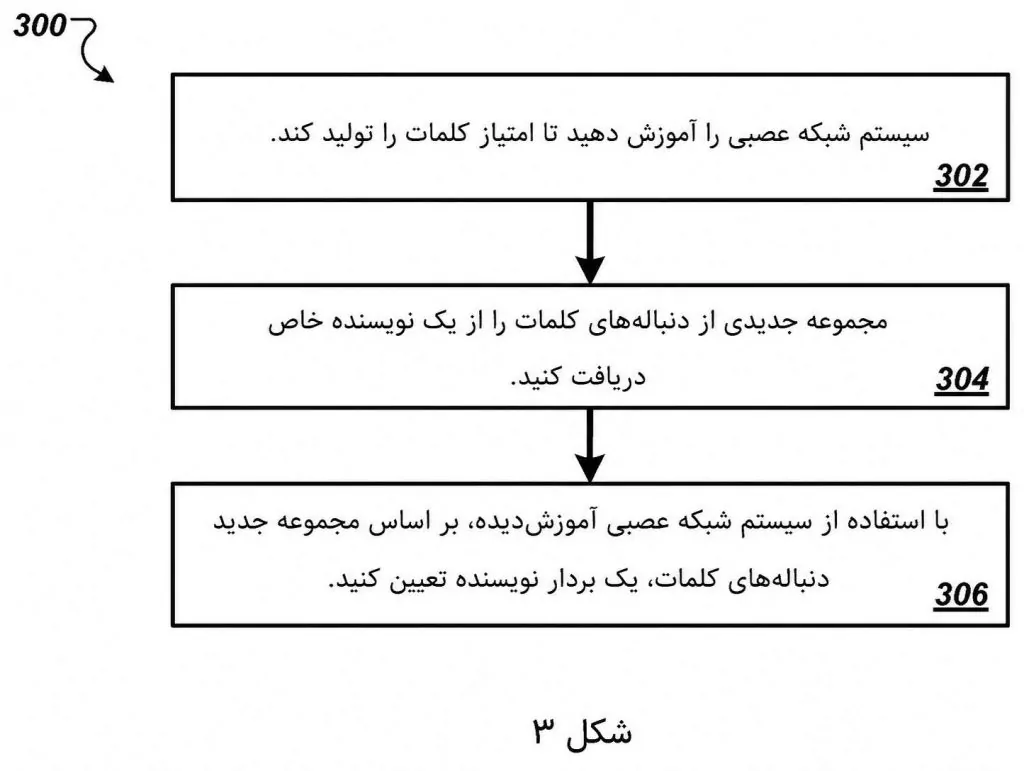
شکل ۳: فرآیند تعیین بردار نویسنده (مربوط به سیستم اول)
شکل ۳ (FIG. 3) در این سند، نمودار جریانی از یک فرآیند نمونه (Process 300) برای تعیین یک بردار نویسنده (Author Vector) از روی مجموعهای از دنبالههای کلمات را نشان میدهد. این فرآیند، چارچوب کلی نحوه یادگیری و استخراج بردار نویسنده برای یک نویسنده جدید با استفاده از مدل آموزشدیده را به تصویر میکشد و از سه مرحله اصلی تشکیل شده است:
۳۰۲. آموزش سیستم شبکه عصبی برای تولید امتیاز کلمات (Step 302)
در این مرحله، سیستم شبکه عصبی (شامل لایههای تعبیهسازی، ترکیب و طبقهبندیکننده) آموزش داده میشود تا بتواند امتیاز کلمات بعدی را پیشبینی کند. طی این فرآیند یادگیری، سیستم مقادیر پارامترهای کلمات (Word Parameters) و پارامترهای طبقهبندیکننده (Classifier Parameters) را بر روی دنباله کلمات آموزشی که نویسندههای متفاوتی دارند، تنظیم و بهینهسازی میکند تا به «مقادیر آموزشدیده» (Trained Values) برسد.
این تنظیمات از طریق محاسبه گرادیان خطا و به کارگیری فرآیند گرادیان کاهشی (Gradient Descent) انجام میشود.
۳۰۴. دریافت مجموعه جدیدی از دنباله کلمات متعلق به یک نویسنده مشخص (Step 304)
سیستم یک مجموعه متنی جدید (شامل جملات، پاراگرافها، کوئریهای جستجو یا هر متن طبیعی دیگر) از یک نویسنده دریافت میکند.
این نویسنده میتواند یک فرد کاملا جدید باشد که متن ها او در مرحله آموزش اولیه شبکه عصبی (مرحله ۳۰۲) استفاده نشده است.
۳۰۶. تعیین بردار نویسنده با استفاده از سیستم آموزشدیده (Step 306)
در این گام نهایی، سیستم با استفاده از متن ها جدید دریافتی و شبکه عصبی آموزشدیده، بردار نویسندهای را که بیانگر ویژگیهای نگارشی اوست تعیین میکند.
نکته کلیدی تکنولوژی: در این مرحله، سیستم مقادیر پارامترهای کلمه و پارامترهای طبقهبندیکننده را کاملا ثابت (Fixed) نگه میدارد.
مدل متن ها نویسنده جدید را به صورت تکرارپذیر پردازش کرده و تنها با اعمال گرادیان کاهشی بر روی پارامترهای نویسنده (Author Parameters)، بردار اختصاصی او را به گونهای تنظیم میکند که به بهترین شکل سبک نگارش، لحن یا شخصیت او را بازتاب دهد.
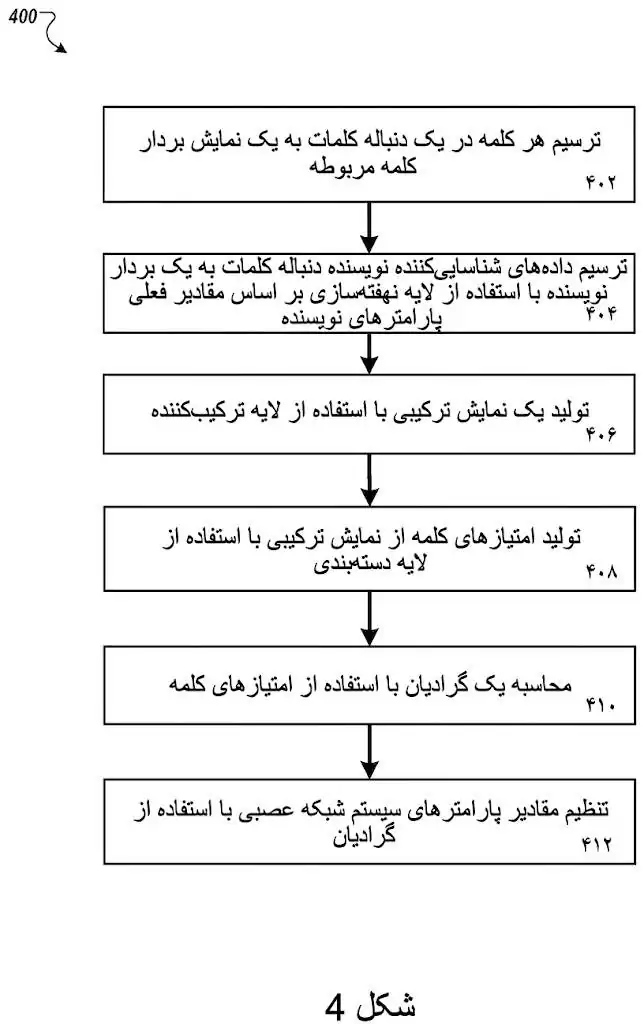
شکل 4: فرآیند آموزش شبکه عصبی (مربوط به سیستم اول)
شکل ۴ (FIG. 4) در این سند، نمودار جریانی از یک فرآیند نمونه (Process 400) برای آموزش سیستم شبکه عصبی روی یک دنباله آموزشی از کلمات متعلق به یک نویسنده خاص را نشان میدهد. هدف کلی این فرآیند، تعیین پارامترهای بهینهسازیشده برای کلمات و بخش طبقهبندیکننده شبکه عصبی است.
۴۰۲. نگاشت کلمات به نمایش برداری (Step 402)
در این مرحله، سیستم تکتک کلمات موجود در دنباله کلمات آموزشی را دریافت کرده و با استفاده از لایه تعبیهسازی (Embedding Layer) به یک نمایش برداری کلمه (Word Vector Representation) تبدیل میکند. این کار بر اساس مقادیر جاری «پارامترهای کلمه» انجام میشود تا برای هر کلمه یک بردار عددی مشخص حاصل شود.
۴۰۴. نگاشت هویت نویسنده به بردار نویسنده (Step 404)
به طور همزمان یا متوالی، سیستم دادههای شناسایی نویسنده (مانند شناسه کاربری یا نویسنده متن) را نیز دریافت کرده و به یک بردار نویسنده (Author Vector) نگاشت میکند. این بردار که ویژگیهای سبک نگارشی نویسنده را خلاصه میکند، مجددا در لایه تعبیهسازی و بر اساس مقادیر جاری «پارامترهای نویسنده» تولید میشود.
۴۰۶. ایجاد نمایش ترکیبی کلمات و نویسنده (Step 406)
در این مرحله، سیستم با استفاده از لایه ترکیب (Combining Layer)، بردارهای کلمات حاصل از مرحله ۴۰۲ و بردار نویسنده حاصل از مرحله ۴۰۴ را با یکدیگر ادغام کرده و یک نمایش ترکیبی (Combined Representation) به وجود میآورد. این لایه میتواند بردارها را به روشهایی نظیر الحاق (Concatenation) یا محاسبه معیارهای تمایل به مرکز مانند میانگینگیری (Averaging) با یکدیگر ترکیب کند.
۴۰۸. پیشبینی و تولید امتیاز کلمات (Step 408)
نمایش ترکیبی تولیدشده به لایه طبقهبندیکننده (Classifier Layer) فرستاده میشود. این لایه بر اساس مقادیر جاری پارامترهای خود، برای هر یک از کلمات موجود در واژهنامه پیشفرض سیستم، یک امتیاز کلمه (Word Score) تولید میکند. این امتیاز نشاندهنده میزان احتمال حضور آن کلمه به عنوان کلمه بعدی در دنباله متنی است.
۴۱۰. محاسبه گرادیان خطا (Step 410)
سیستم امتیازات پیشبینیشده در مرحله قبل را با خروجی هدف (یعنی کلمهای که در واقعیت در سند اصلی بلافاصله پس از دنباله کلمات آمده است) مقایسه میکند. از طریق تفاوت میان پیشبینی و واقعیت، میزان خطا مشخص شده و سپس گرادیان (Gradient) یک تابع هدف بر اساس این خطا محاسبه میشود.
۴۱۲. تنظیم و بهروزرسانی پارامترهای شبکه (Step 412)
در گام نهایی، سیستم از گرادیان محاسبهشده برای اصلاح و تنظیم مقادیر جاری پارامترهای شبکه عصبی استفاده میکند. ابتدا پارامترهای لایه طبقهبندیکننده با استفاده از گرادیان تنظیم شده و سپس با استفاده از الگوریتم پسانتشار خطا (Backpropagation)، پارامترهای موجود در لایه تعبیهسازی (شامل پارامترهای کلمات و پارامترهای نویسنده) بهروزرسانی میشوند.
این فرآیند (چرخه ۴۰۲ تا ۴۱۲) به صورت تکراری برای دنبالههای متنی متعدد از نویسندگان مختلف انجام میشود تا سیستم در نهایت به مقادیر بهینه و آموزشدیدهای از پارامترها دست یابد.
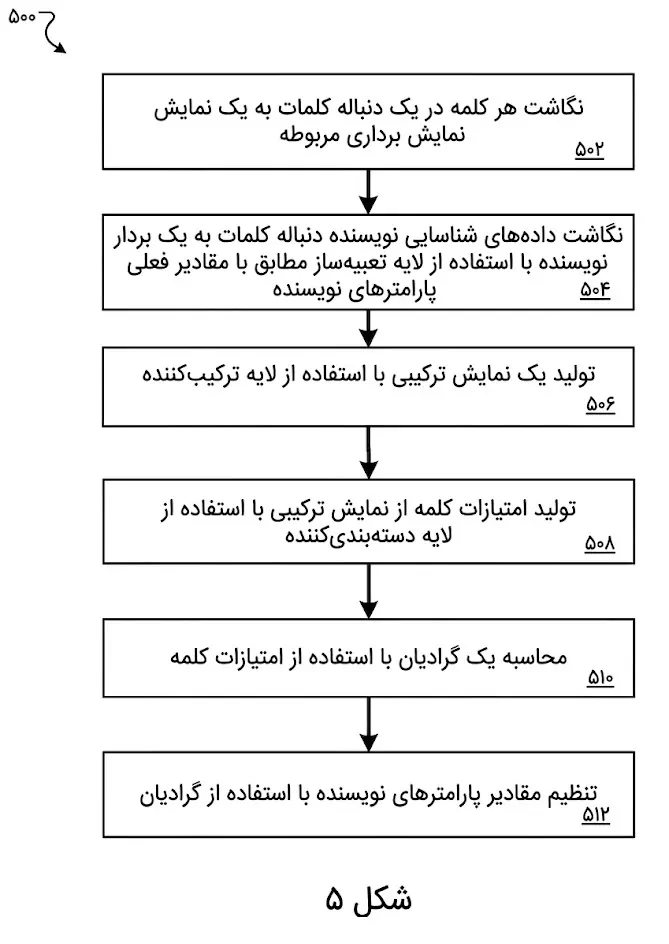
شکل ۵: فرآیند تنظیم بردار نویسنده (برای متن ها جدید)
شکل ۵ (FIG. 5) نمودار جریانی از یک فرآیند نمونه (Process 500) برای تنظیم و اصلاح نمایش بردار نویسنده بر روی مجموعهای از دنباله کلمات را نشان میدهد. این فرآیند معمولا بر روی یک سیستم بردار نویسنده آموزشدیده (مانند مدلی که فرآیند شکل ۴ را طی کرده است) اجرا میشود تا بتوان بردار ویژگیهای یک نویسنده جدید را استخراج کرد یا بردار نویسنده موجود را بیشتر بهبود بخشید.
جزئیات گامبهگام این فرآیند (مراحل ۵۰۲ تا ۵۱۲) به شرح زیر است:
۵۰۲. دریافت دنباله کلمات جدید (Step 502)
در اولین قدم، سیستم یک دنباله از کلمات را از مجموعهای از متنها که همگی به یک نویسنده مشخص منتسب هستند، دریافت میکند. این دنبالهها معمولا طول ثابتی دارند و میتوانند شامل جملاتی باشند که در زمان آموزش اولیه مدل وجود نداشتهاند و حتی ممکن است توسط نویسندهای کاملا جدید نوشته شده باشند.
۵۰۴. نگاشت کلمات به بردارها با پارامترهای آموزشدیده (Step 504)
سیستم تکتک کلمات دنباله متنی را با استفاده از لایه تعبیهسازی (Embedding Layer) پردازش میکند. در این مرحله، سیستم از مقادیر آموزشدیده و ثابتشدهی پارامترهای کلمه استفاده میکند تا کلمات را به نمایشهای برداری (Word Vectors) تبدیل کند.
۵۰۶. نگاشت شناسه نویسنده و ایجاد نمایش ترکیبی (Step 506)
در این مرحله، سیستم دو کار انجام میدهد: ۱. شناسه نویسنده را با استفاده از لایه تعبیهسازی و بر اساس مقادیر جاری (Current) پارامترهای نویسنده به یک بردار نویسنده تبدیل میکند. ۲. سپس با استفاده از لایه ترکیب (Combining Layer)، بردار نویسنده جاری و بردارهای کلمات مرحله قبل را با هم ادغام میکند (مثلا از طریق الحاق یا میانگینگیری) تا یک نمایش ترکیبی ایجاد شود.
۵۰۸. پیشبینی امتیاز کلمات با پارامترهای ثابت (Step 508)
نمایش ترکیبی حاصل، به لایه طبقهبندیکننده (Classifier Layer) منتقل میشود. سیستم بر اساس مقادیر آموزشدیده و ثابتشدهی پارامترهای طبقهبندیکننده، امتیازهایی را برای تمام کلمات واژهنامه محاسبه میکند تا احتمال حضور هر کلمه به عنوان کلمه بعدی دنباله را پیشبینی کند.
۵۱۰. محاسبه گرادیان خطا (Step 510)
سیستم خطای بین امتیازات کلمات پیشبینیشده و خروجی هدف واقعی (یعنی کلمهای که در سند واقعی بلافاصله بعد از دنباله کلمات آمده است) را محاسبه میکند. سپس با استفاده از این تفاوت و خطا، گرادیان یک تابع هدف را به دست میآورد.
۵۱۲. تنظیم و بهروزرسانی پارامترهای نویسنده (Step 512)
این مرحله، گام کلیدی و متمایزکننده این فرآیند است؛ سیستم مقادیر پارامترهای کلمه و پارامترهای طبقهبندیکننده را کاملا ثابت و بدون تغییر نگه میدارد و از گرادیان خطا از طریق الگوریتم پسانتشار (Backpropagation) فقط برای بهروزرسانی و تنظیم پارامترهای نویسنده در لایه تعبیهسازی استفاده میکند. مقادیر بهروزرسانیشدهی این پارامترها در واقع بردار نویسنده را برای این تکرار تعریف میکنند.
تعیین بردار نهایی
اگر دنباله پردازششده، آخرین بخش از متن نویسنده باشد، سیستم از این پارامترهای بهروزرسانیشده برای تعیین بردار نویسنده نهایی استفاده میکند که ویژگیهای سبک نگارشی، سبک ارتباطی یا شخصیت نویسنده را در خود خلاصه کرده است. در غیر این صورت، این مقادیر بهروزرسانیشده به عنوان ورودی برای پردازش دنباله کلمات بعدی نویسنده مورد استفاده قرار میگیرند.
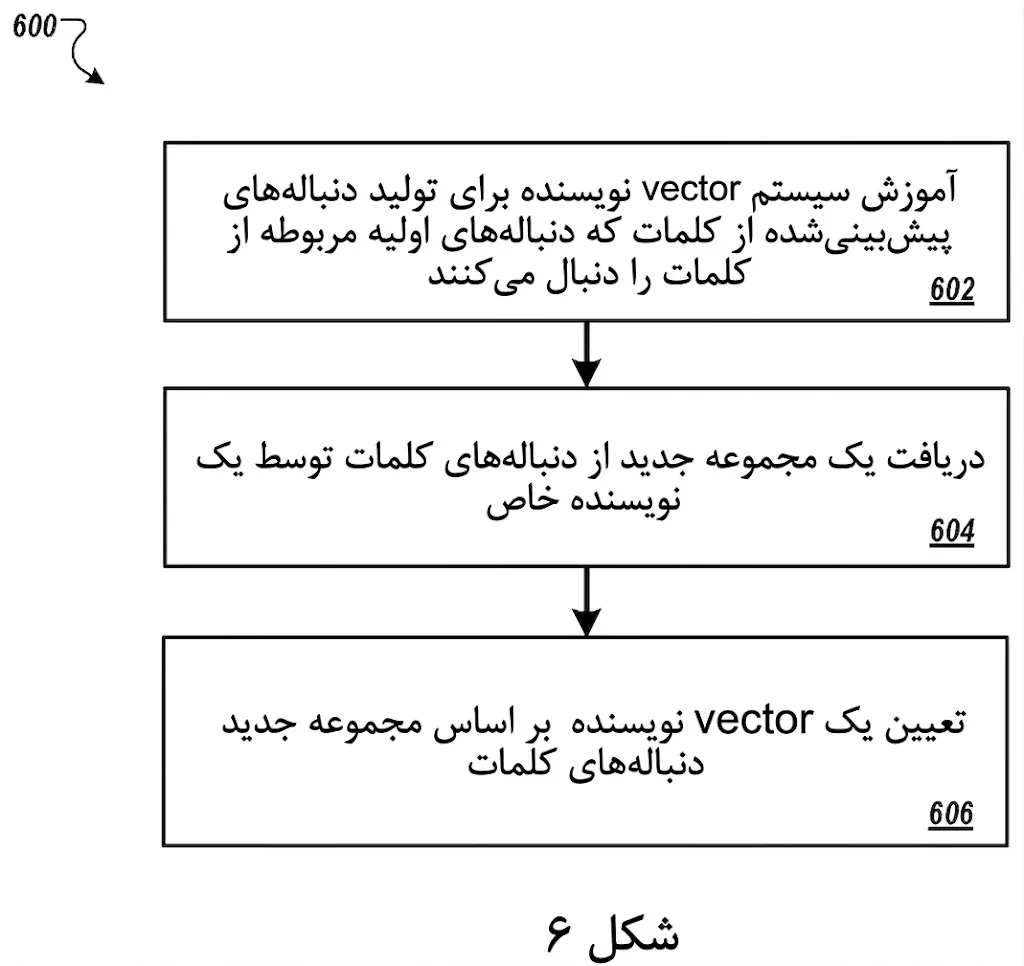
شکل ۶: فرآیند تعیین بردار نویسنده (در سیستم LSTM)
شکل ۶ (FIG. 6) در این سند، نمودار جریانی از یک فرآیند نمونه دیگر (Process 600) برای تعیین بردار نویسنده (Author Vector) از روی مجموعهای از دنبالههای کلمات را نشان میدهد.
تفاوت اصلی این شکل با شکل ۳ در این است که شکل ۶ بر پایه معماری پیشرفتهتر توالیبهتوالی (Sequence-to-Sequence یا Seq2Seq) مجهز به شبکههای عصبی برگشتی LSTM طراحی شده است، در حالی که شکل ۳ مدل سادهتر پیشبینی کلمه بعدی را توصیف میکرد.
این فرآیند از سه مرحله اساسی تشکیل شده است:
۶۰۲. آموزش سیستم بردار نویسنده برای تولید دنبالههای بعدی پیشبینیشده (Step 602)
در این مرحله، سیستم عصبی برای پیشبینی دنبالهای از کلمات (به جای تککلمه) که بلافاصله پس از دنباله اولیه میآیند، آموزش داده میشود.
اجزای سیستم: این مدل شامل یک شبکه عصبی برگشتی رمزگذار (Encoder LSTM)، یک لایه تعبیهسازی (Embedding Layer)، یک زیرسیستم ترکیبکننده (Combining Subsystem) و یک شبکه عصبی برگشتی رمزگشا (Decoder LSTM) است.
نحوه کارکرد: سیستم متن اولیه را با طول متغیر از طریق Encoder LSTM پردازش کرده و آن را به یک نمایش میانی با طول ثابت (برگرفته از آخرین حالت پنهان یا Hidden State لایه رمزگذار) تبدیل میکند. این نمایش با بردار نویسنده ترکیب شده و به عنوان ورودی اولیه به Decoder LSTM داده میشود تا دنباله بعدی را کلمه به کلمه تولید کند.
بهروزرسانی عمومی: در حین آموزش، تفاوت (خطا) بین دنباله پیشبینیشده و دنباله واقعی بعدی در متن ها آموزشی محاسبه شده و از گرادیان خطا برای بهروزرسانی پارامترهای تمام بخشهای سیستم (از جمله Encoder، Decoder و لایه تعبیهسازی) استفاده میشود.
۶۰۴. دریافت مجموعهای جدید از دنبالههای کلمات متعلق به یک نویسنده مشخص (Step 604)
پس از پایان موفقیتآمیز فاز آموزش و ثابت شدن ساختار کلی مدل، سیستم مجموعهای از متنهای جدید (شامل دنبالههای اولیه و دنبالههای واقعی بعدی آنها) را از یک نویسنده مشخص دریافت میکند.
این متن ها ممکن است متعلق به نویسندهای کاملا جدید باشند که سیستم پیش از این هرگز سبک نوشتاری او را در فاز آموزش ندیده است.
۶۰۶. تعیین بردار نویسنده با استفاده از سیستم آموزشدیده (Step 606)
در این گام نهایی، سیستم بردار نویسنده جدید را به صورت تکرارپذیر (Iterative) تعیین میکند.
نکته کلیدی بهینهسازی: سیستم برای پردازش متن نویسنده جدید، پارامترهای آموزشدیده در بخشهای Encoder LSTM، Decoder LSTM و زیرسیستم ترکیب را کاملا ثابت (Fixed) نگه میدارد و تغییر نمیدهد.
سیستم با عبور دادن دنبالههای اولیه نویسنده جدید از شبکه، خروجیها را تولید کرده، خطا را نسبت به دنبالههای بعدی واقعی میسنجد و صرفا پارامترهای نویسنده را در لایه تعبیهسازی از طریق گرادیان خطا بهروزرسانی میکند. بردار نهایی حاصل از این بهینهسازی، به عنوان بردار مشخصه سبک و لحن آن نویسنده ثبت میشود.
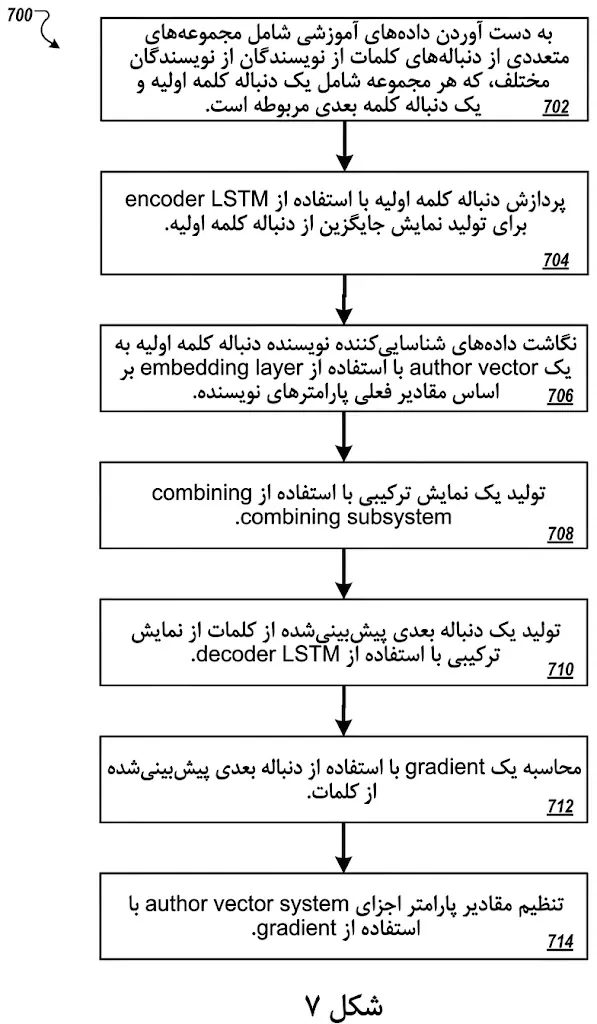
شکل ۷: فرآیند آموزش شبکه مبتنی بر LSTM
شکل ۷ (FIG. 7) در این سند، نمودار جریانی از یک فرآیند نمونه (Process 700) را برای آموزش سیستم بردار نویسنده (Author Vector System) بر روی یک دنباله کلمات متنی متعلق به یک نویسنده خاص نشان میدهد. این فرآیند مکمل شکل ۶ است و جزئیات دقیق فرآیند یادگیری اولیه را در معماری پیشرفته Seq2Seq LSTM توصیف میکند.
در ادامه، جزئیات هر یک از مراحل شمارهگذاریشده در این شکل (مراحل ۷۰۲ تا ۷۱۴) به زبان ساده و گامبهگام توضیح داده شده است:
۷۰۲. دریافت دادههای آموزشی (Step 702)
در اولین قدم، سیستم دادههای متنی مربوط به نویسندگان مختلف را دریافت میکند. این دادهها شامل جفتهای متنی هستند: یک «دنباله کلمات اولیه» (Initial Sequence) با طول متغیر، و یک «دنباله کلمات بعدی» (Next Sequence) که در متن ها واقعی نویسنده، بلافاصله پس از دنباله اولیه ظاهر شده است.
۷۰۴. پردازش دنباله اولیه توسط Encoder LSTM (Step 704)
سیستم کلمات دنباله اولیه را به صورت کلمه به کلمه و به ترتیب ورود، به یک شبکه عصبی برگشتی رمزگذار (Encoder LSTM) میدهد. این شبکه با پردازش هر کلمه، حالت پنهان خود را بهروزرسانی میکند. در نهایت، پس از پردازش آخرین کلمه، آخرین حالت پنهان رمزگذار به عنوان یک نمایش جایگزین و با طول ثابت (Alternative Representation) از کل جمله اولیه استخراج میشود.
۷۰۶. نگاشت شناسه نویسنده به بردار نویسنده (Step 706)
به طور همزمان، دادههای شناسایی نویسنده (مانند شناسه عددی او) وارد لایه تعبیهسازی (Embedding Layer) سیستم میشود. این لایه بر اساس مقادیر جاری «پارامترهای نویسنده»، شناسه او را به یک بردار نویسنده (Author Vector) نگاشت میکند که نشاندهنده سبک سبکشناختی او در این تکرار است.
۷۰۸. ایجاد نمایش ترکیبی نویسنده و متن (Step 708)
در این مرحله، سیستم با استفاده از زیرسیستم ترکیبکننده (Combining Subsystem)، نمایش متنی حاصل از رمزگذار (مرحله ۷۰۴) و بردار نویسنده (مرحله ۷۰۶) را با یکدیگر ادغام میکند. این ادغام معمولا از روشهای از پیشتعیینشدهای مانند الحاق (Concatenation)، میانگینگیری (Averaging) یا جمعکردن (Summing) بردارها انجام میشود.
۷۱۰. پیشبینی دنباله بعدی کلمات توسط Decoder LSTM (Step 710)
نمایش ترکیبی حاصل، برای مقداردهی اولیه به شبکه عصبی برگشتی رمزگشا (Decoder LSTM) به کار میرود. رمزگشا با استفاده از این اطلاعات و وضعیت اولیه، شروع به تولید کلمه به کلمه دنباله کلمات بعدی پیشبینیشده میکند و در هر گام احتمالات مربوط به کلمه بعدی را به عنوان امتیاز خروجی ارائه میدهد.
۷۱۲. محاسبه گرادیان خطا (Step 712)
پس از این که Decoder دنباله بعدی را پیشبینی کرد، سیستم این خروجی پیشبینیشده را با خروجی واقعی و هدف (همان دنباله بعدی واقعی موجود در متن ها آموزشی) مقایسه میکند. با محاسبه تفاوت (خطا) میان این دو، گرادیان تابع هدف بر اساس میزان خطا محاسبه میشود.
۷۱۴. بهروزرسانی پارامترهای تمام اجزای سیستم (Step 714)
در گام نهایی آموزش، از گرادیان بهدستآمده برای بهروزرسانی و بهینهسازی پارامترهای تمام بخشهای سیستم استفاده میشود. سیستم با استفاده از الگوریتم پسانتشار خطا (Backpropagation)، مقادیر جاری پارامترهای Encoder LSTM، Decoder LSTM، لایه تعبیهسازی (Embedding) و (در صورت لزوم) زیرسیستم ترکیب را اصلاح میکند تا در تکرارهای بعدی خطای پیشبینی کاهش یابد.
این چرخه به صورت مداوم بر روی هزاران جفت متن از نویسندگان گوناگون تکرار میشود تا سیستم در نهایت به پارامترهای بهینهسازیشده برای کلمات و ساختارهای زبانی دست یابد.
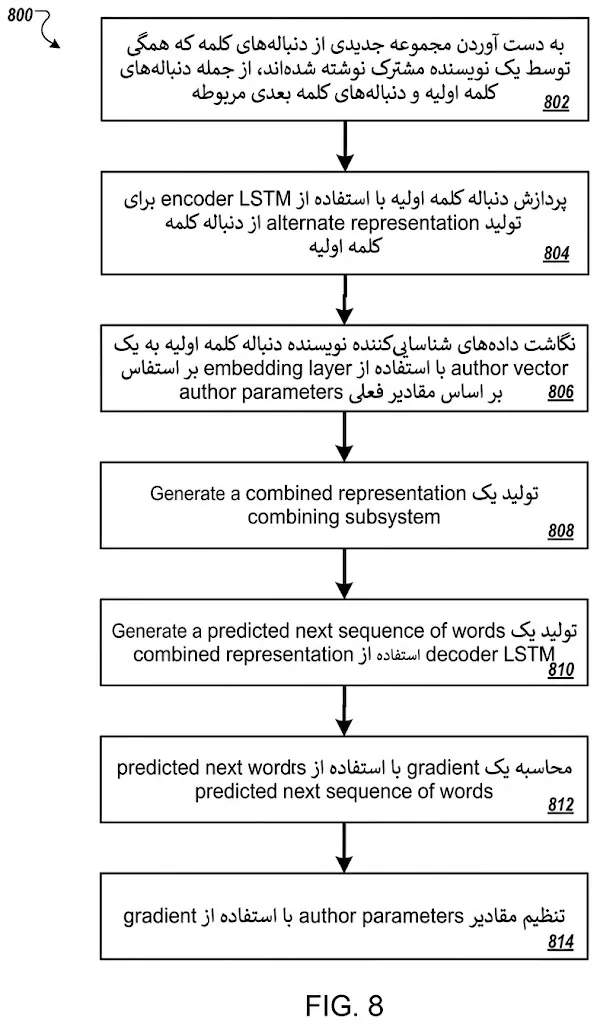
شکل ۸: فرآیند تنظیم بردار نویسنده (برای سیستم Seq2Seq LSTM)
شکل ۸ (FIG. 8) در این سند، نمودار جریانی از یک فرآیند نمونه دیگر (Process 800) را برای تنظیم و اصلاح نمایش بردار نویسنده بر روی مجموعهای از دنباله کلمات نشان میدهد. این فرآیند، نحوه استخراج و یادگیری بردار نویسنده را برای متن ها جدید بر پایه مدل پیشرفته Seq2Seq LSTM به تصویر میکشد.
بر خلاف شکل ۵ که بر اساس پیشبینی سادهی تککلمه بعدی عمل میکرد، در فرآیند شکل ۸ تنظیم بردار نویسنده بر مبنای توانایی مدل در پیشبینی دقیق یک دنباله کامل از کلمات بعدی صورت میگیرد.
در ادامه، جزئیات گامبهگام مراحل شمارهگذاریشده در شکل ۸ (مراحل ۸۰۲ تا ۸۱۴) توضیح داده شده است:
۸۰۲. دریافت مجموعه جدیدی از دنباله کلمات (Step 802)
سیستم مجموعهای از متن ها جدید متعلق به یک نویسنده مشخص را برای شروع فرآیند پردازش دریافت میکند. این متن ها ممکن است در فاز آموزش اولیه مدل استفاده نشده باشند و متعلق به یک نویسنده کاملا جدید باشند (یا جهت بهبود و اصلاح بردار نویسندهای که از قبل در سیستم وجود دارد به کار روند). این متن ها شامل جفتهای متنی به صورت «دنباله کلمات اولیه» و «دنباله بعدی واقعی» هستند. مراحل بعدی (۸۰۴ تا ۸۱۴) به صورت تکرارپذیر برای تکتک دنبالههای اولیه در این مجموعه متنی اجرا میشوند.
۸۰۴. پردازش دنباله اولیه توسط Encoder LSTM (Step 804)
سیستم دنباله کلمات اولیه را دریافت کرده و آن را با استفاده از شبکه عصبی برگشتی رمزگذار (Encoder LSTM) پردازش میکند تا یک نمایش جایگزین (Alternative Representation) با طول ثابت از کل جمله به دست آید. در این گام، سیستم از مقادیر آموزشدیده و ثابتشدهی پارامترهای رمزگذار استفاده میکند و این تنظیمات در طول فرآیند تغییر نمیکنند.
۸۰۶. نگاشت شناسه نویسنده به بردار نویسنده جاری (Step 806)
به طور همزمان، سیستم شناسه یا اطلاعات شناسایی نویسنده را دریافت کرده و با استفاده از لایه تعبیهسازی (Embedding Layer)، آن را به یک بردار نویسنده جاری نگاشت میکند. این نگاشت بر اساس مقادیر جاری (Current) پارامترهای نویسنده در این تکرار صورت میپذیرد.
۸۰۸. ایجاد نمایش ترکیبی با زیرسیستم ترکیب (Step 808)
در این مرحله، سیستم با استفاده از زیرسیستم ترکیبکننده (Combining Subsystem)، نمایش متنی حاصل از رمزگذار (مرحله ۸۰۴) و بردار نویسنده جاری (مرحله ۸۰۶) را ادغام میکند. این کار میتواند به روشهای ادغام ثابت ریاضی (مانند الحاق، میانگینگیری یا جمع بردارها) صورت گیرد یا بر اساس مقادیر آموزشدیده و ثابت پارامترهای این زیرسیستم انجام شود.
۸۱۰. پیشبینی دنباله بعدی توسط Decoder LSTM (Step 810)
نمایش ترکیبی تولیدشده به عنوان ورودی اولیه برای مقداردهی به حالتهای شبکه عصبی برگشتی رمزگشا (Decoder LSTM) مورد استفاده قرار میگیرد. سپس رمزگشا بر اساس این اطلاعات، اقدام به تولید و پیشبینی کلمه به کلمه دنباله بعدی میکند.
۸۱۲. محاسبه گرادیان خطا (Step 812)
سیستم دنباله کلمات بعدی پیشبینیشده توسط Decoder را با دنباله کلمات بعدی واقعی (موجود در متن ها هدف و اصلی نویسنده) مقایسه کرده و میزان تفاوت یا خطای پیشبینی را اندازه میگیرد. سپس از روی این خطا، گرادیان یک تابع هدف محاسبه میشود.
۸۱۴. بهروزرسانی پارامترهای نویسنده در لایه تعبیهسازی (Step 814)
سیستم با پسانتشار (Backpropagation) گرادیان محاسبهشده، تنها مقادیر پارامترهای نویسنده را در لایه تعبیهسازی بهروزرسانی میکند. در این فرآیند، مقادیر پارامترهای سایر اجزای شبکه عصبی (مانند Encoder LSTM، Decoder LSTM و زیرسیستم ترکیب) کاملا ثابت و بدون تغییر نگه داشته میشوند تا ساختار کلی زبان حفظ شود و فقط ویژگیهای نویسنده شخصیسازی شود.
این چرخه برای تمام دنبالههای متنی نویسنده تکرار شده و مقادیر نهایی این پارامترها در تکرار آخر، بردار نویسنده نهایی او را تشکیل میدهند.
سؤالات متداول
آیا گوگل با استفاده از الگوریتم بردارهای نویسنده میتواند بفهمد متن را هوش مصنوعی نوشته است؟
بله. همانطور که هر انسان دارای امضای نوشتاری و بردار سبکشناختی منحصربهفرد خود است، متون تولیدشده توسط هوش مصنوعی نیز از الگوها، اولویتها و احتمالات آماری خاص و بسیار پیشبینیپذیری پیروی میکنند. فناوری ثبتشده گوگل دارای لایهای پیشرفته برای تایید اصالت نویسنده است. این سیستم بردار متن جدید را محاسبه کرده و با بردار مرجع نویسنده واقعی مقایسه میکند. اگر متن توسط هوش مصنوعی نوشته شده باشد، فاصله ریاضی بردار جدید از بردار واقعی نویسنده فراتر رفته و تفاوت فاحش ساختاری آن، سیستم را به این نتیجه میرساند که متن متعلق به نویسنده ادعاشده نیست. در واقع تغییر ناگهانی لحن به سبک ماشینی و یکنواخت هوش مصنوعی، بهسرعت توسط الگوریتمهای تایید اصالت کشف میشود.
آیا این سیستم بر روی نتایج جستجویی که کاربران نهایی میبینند نیز تاثیر مستقیمی میگذارد؟
بله، این فناوری ارتباط مستقیمی با شخصیسازی نتایج جستجو و تبلیغات دارد. سیستم گوگل میتواند بر اساس سبک نگارشی کاربران یا لحن جستجوهای گذشتهشان، آنها را در خوشههای شخصیتی مختلفی قرار دهد. سپس رتبهبندی صفحات وب، محتوای چندرسانهای پیشنهادی و حتی تبلیغات نمایشدادهشده به کاربر، بر اساس بردار شخصیتی او شرطیسازی میشود تا مرتبطترین و جذابترین محتوا برای هر تیپ شخصیتی ارائه گردد. در نتیجه، کاربری که دارای لحن جدی و تخصصی است، با جستجوی یک عبارت یکسان، نتایج کاملاً متفاوتی نسبت به کاربری با لحن عامیانه دریافت خواهد کرد
من به عنوان یک تولیدکننده محتوا و سئوکار، باید چه تغییری در استراتژی تولید محتوای سایتم ایجاد کنم؟
حیاتیترین اقدام، حفظ ثبات عمیق در لحن و سبک نگارش است. الگوریتم گوگل نویسندگان را بر اساس سبک ارتباطی و الگوهای کلامی منحصربهفردشان خوشهبندی میکند . اگر مقالاتی که به نام یک نویسنده خاص در سایت شما منتشر میشوند، مدام تغییر سبک دهند (مثلاً یک روز بسیار فنی، روز دیگر عامیانه و روز بعد به سبک نگارش ماشینی)، بردار نویسنده او در سیستم دچار نوسان و آشفتگی آماری شدید میشود. این بی ثباتی باعث میشود سیستم نتواند پروفایل پایداری برای نویسنده شما بسازد و در تایید اصالت نوشتههای او ناتوان بماند. یکدستی و پایداری در سبک نگارش، اعتماد آماری الگوریتم به اصالت محتوا را به حداکثر میرساند
آیا داشتن یک لحن ثابت و بردار نویسنده مشخص، برای رتبه گرفتن در نتایج جستجو کافی است؟
خیر، این یک تصور اشتباه در سئو است. ثبات لحن به گوگل کمک میکند تا اصالت و هویت نویسنده را به درستی تایید کند، اما رتبهبندی نهایی محتوا به معیارهای چندبعدی کیفیت و ارزش اطلاعات وابسته است. اگر نوشته شما لحن کاملاً یکدست و منحصربهفردی داشته باشد اما فاقد اطلاعات ارزشمند برای کاربر باشد، کپی باشد یا نیازی از مخاطب برطرف نکند، رتبهای دریافت نخواهد کرد. سیستمهای رتبهبندی گوگل فاکتورهای بیشماری مانند میزان رضایت کاربر، تازگی محتوا، اعتبار ساختاری و لینکسازی را بررسی میکنند که کاملاً فراتر از محدوده این پتنت هستند.
آیا این الگوریتم به این معنی است که هر نویسنده باید تا ابد فقط با یک سبک بنویسد تا رتبه سئوی سایت آسیب نبیند؟
خیر، این یک سوءتفاهم بزرگ در استراتژی محتواست. شبکههای عصبی عمیق بهگونهای طراحی شدهاند که میتوانند تنوع سبک و حتی لحنهای ترکیبی را در قالب ویژگیهای پنهان ریاضی پردازش کنند. علاوه بر این، تغییر سبک هوشمندانه یا تکامل لحن نویسنده در طول زمان، به مرور و با فرآیندهای پویای بهروزرسانی بردار همگام میشود. سئوکاران نباید خلاقیت و تنوع نوشتاری نویسندگان خود را به بهانه سئو سرکوب کنند؛ زیرا خلق ارزش واقعی برای مخاطب و رضایت کاربران همیشه وزن و اهمیت بسیار بیشتری در رتبهبندی نهایی دارد.
اگر از هوش مصنوعی برای نوشتن پیشنویس اولیه استفاده کنیم و سپس آن را بازنویسی کنیم، آیا این الگوریتم باز هم متوجه استفاده از ابزار میشود؟
این فناوری به خودی خود به دنبال مچگیری از ابزارهای کمکی نیست. تمرکز این سیستم روی تطبیق ویژگیهای سبکشناختی متن نهایی با بردار مرجع نویسنده است. اگر فرآیند بازنویسی و ویراستاری شما به قدری عمیق و طبیعی باشد که الگوهای کلامی، ساختار جملات، نحوه چیدمان پاراگرافها و دایره واژگان شخصی شما را به متن بازگرداند، بردار خروجی با هویت شما کاملاً همخوانی خواهد داشت. بنابراین، به جای ترس از ابزارها، تمرکز اصلی سئوکاران باید روی افزودن تجربه شخصی، ارزش اطلاعاتی و امضای نوشتاری واقعی به محتوای نهایی باشد.