Boilerplate چیست و گوگل چگونه آن را تشخیص میدهد؟
اگر تا امروز هنگام بررسی سئوی سایت خود به عبارت «Boilerplate» برخوردهاید و ندانستهاید دقیقا منظور از آن چیست، این مقاله برایتان نوشته شده. در ادامه با تعریف دقیق این اصطلاح، انواع رایج آن در یک صفحه وب، و مهمتر از همه، روشهایی که گوگل برای تشخیص آن استفاده میکند آشنا میشوید.
Boilerplate چیست؟
ریشه واژه Boilerplate در صنعت چاپ
واژه بویلرپلیت اصالتا از صنعت چاپ و روزنامهنگاری گرفته شده است. در گذشته، ناشران از ورقهای فلزی از پیش آماده شده شبیه ورقهای فولادی بهکاررفته در دیگهای بخار (boiler) برای چاپ متون تکراری و استاندارد مثل تبلیغات، اطلاعیهها یا اخبار عمومی در روزنامههای مختلف استفاده میکردند. این صفحات بدون تغییر یا با تغییرات بسیار کم در نشریات گوناگون تکرار میشدند و به همین دلیل نام «Boilerplate» به خود گرفتند.
با گذر زمان و ورود این اصطلاح به دنیای دیجیتال، معنای آن گسترش یافت و امروز به هر محتوا یا کدی گفته میشود که بدون تغییر یا با تغییر اندک در جاهای مختلف تکرار میشود.
در برنامه نویسی
به قطعه کدهایی گفته میشود که باید در بخشهای مختلف یک برنامه یا در پروژههای گوناگون، بدون تغییر یا با کمترین تغییر ممکن نوشته و تکرار شوند. این کدها معمولا منطق اصلی (Business Logic) یا عملکرد خاصی را به برنامه اضافه نمیکنند، بلکه صرفا برای راهاندازی اولیه، پیکربندی، یا رعایت ساختار الزامی یک زبان برنامهنویسی و فریمورک نوشته میشوند.
در وب و سئو
به بخشهایی از یک صفحه گفته میشود که در تمام یا بیشتر صفحات یک وبسایت تکرار میشوند و ارتباط مستقیمی با محتوای اصلی آن صفحهی خاص ندارند. بهعبارت دیگر، اگر محتوای یک بخش از صفحه، بدون تغییر معنادار، در دهها یا صدها صفحه دیگر همان سایت هم دیده شود، آن بخش را Boilerplate مینامیم.
نمونه کلاسیک آن، اطلاعیه حقنشر (copyright notice) در پایین صفحات یک سایت است؛ همین متن ثابت که در هر صفحه از سایت تکرار میشود، دقیقا تعریف بویلرپلیت را نشان میدهد.
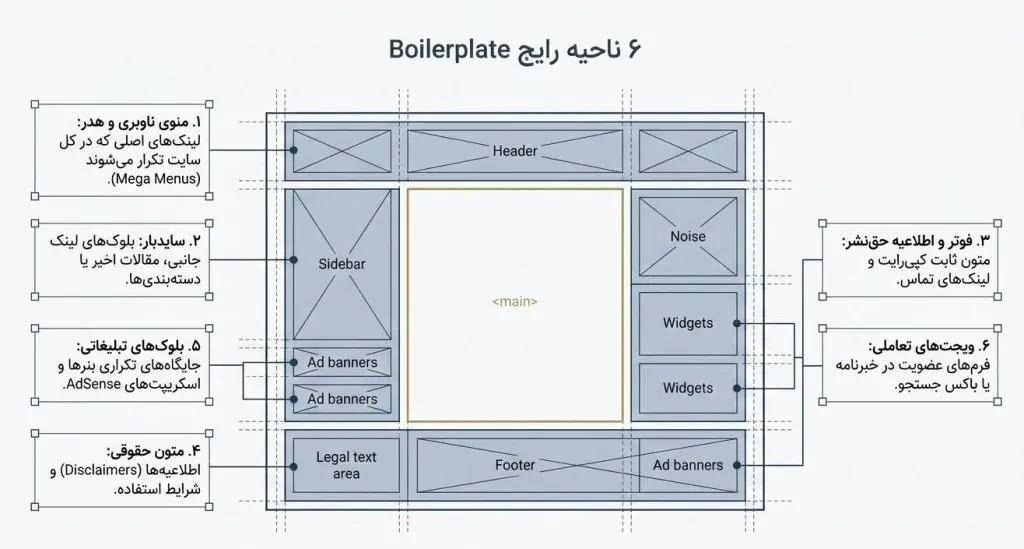
انواع رایج Boilerplate در یک صفحه وب
قبل از اینکه به روشهای تشخیص گوگل برسیم، بهتر است بدانیم دقیقا کدام بخشهای یک صفحه معمولا بهعنوان Boilerplate (محتوای تکراری و غیراصلی) شناخته میشوند. بهطور کلی، هر بخش از صفحه که در صفحات متعدد یک وبسایت تکرار شده باشد یا ارتباط مستقیمی با موضوع و محتوای اصلی آن صفحه نداشته باشد، Boilerplate محسوب میشود.
منوی ناوبری و هدر سایت
منوی اصلی سایت که در هدر یا بخشهای بالایی/کناری هر صفحه ظاهر میشود و امکان جابهجایی بین بخشهای مختلف (مانند صفحه اصلی، درباره ما، دستهبندیها) را به کاربر میدهد، یکی از رایجترین نمونههای Boilerplate است. این بخش معمولا در ۱۰۰٪ صفحات سایت با محتوای ثابت تکرار میشود.
سایدبار و بلوکهای لینک جانبی
سایدبارها معمولا حاوی لینکهای دستهبندی، ویجتهای تکراری، لیست «مطالب مرتبط»، «پربازدیدترینها» یا آخرین نوشتهها هستند. تراکم بالای لینک نسبت به متن (Link-to-Text Ratio) در این بخشها یکی از سیگنالهای اصلی برای تشخیص آنها بهعنوان بخش غیرمرتبط با محتوای اصلی است.
فوتر و اطلاعیه حقنشر
فوتر سایت که در پایینترین بخش صفحات قرار دارد، شامل لینکهای استاندارد و اطلاعیه حقنشر (Copyright) است. این بخش مستقل از موضوع صفحه، عینا در تمام صفحات تکرار میشود.
اطلاعیهها و متون حقوقی
بخشهای مربوط به شرایط استفاده از خدمات (Terms of Service)، سیاست حریم خصوصی (Privacy Policy)، بیانیههای سلب مسئولیت حقوقی یا هشدارهای کوکی که ساختاری یکسان در صفحات دارند.
بلوکهای تبلیغاتی
بلوکهای تبلیغاتی به خصوص تبلیغات شبکههای تبلیغاتی شناختهشده جزو Boilerplate محسوب میشوند، چون معمولا محتوایشان با موضوع اصلی صفحه بیارتباط است و از قالبهای تکراری با ساختار مشخص (لینکهای خارج از دامنه، اسکریپتهای ردیابی و شناسهی یکسان) پیروی میکنند.
فرمها و ویجتهای تعاملی تکراری
بخشهای کاربردی ثابت مانند نوار جستجوی سایت (Search Bar)، فرمهای ورود/ثبتنام (Login/Sign-up)، فرم عضویت در خبرنامه و دکمههای اشتراکگذاری در شبکههای اجتماعی که در تمام صفحات قالبی یکسان دارند.
چرا Boilerplate برای سئو اهمیت دارد؟
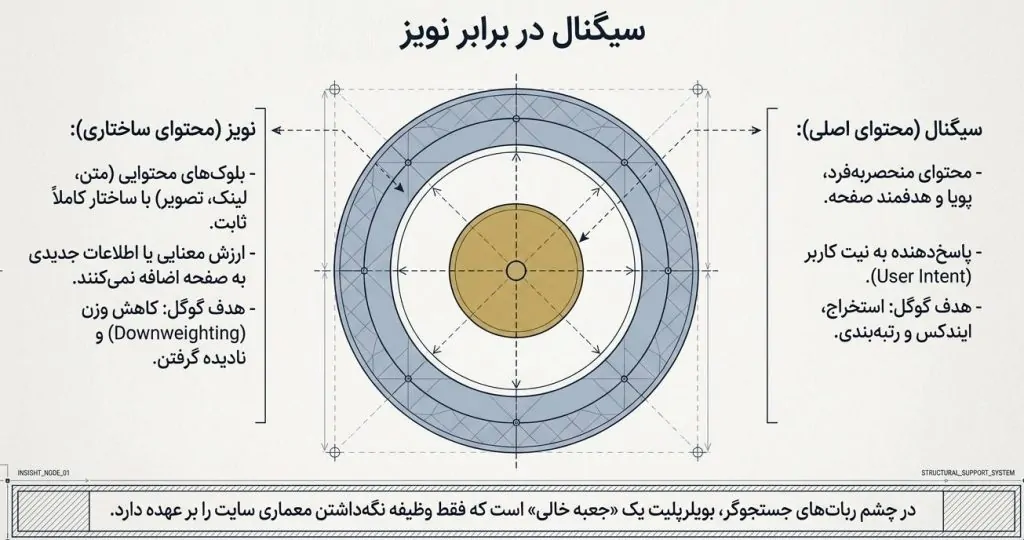
شناسایی و تفکیک محتوای اصلی از بخشهای تکراری (بویلرپلیت) یکی از مراحل کلیدی در پیشپردازش و تحلیل صفحات وب توسط موتورهای جستجو است. اگر گوگل نتواند این بخشها را بهدرستی از متن اصلی جدا کند، ارزیابی موضوعی و رتبهبندی صفحه دچار اختلال میشود. اهمیت این موضوع در سئو را میتوان در ۵ محور اصلی خلاصه کرد:
۱. تشخیص موضوع اصلی و ایندکسگذاری دقیق
اگر موتور جستجو محتوای تکراری صفحه مانند منو، سایدبار یا فوتر را با همان وزن محتوای اصلی پردازش کند، در تشخیص موضوع واقعی صفحه دچار خطا میشود. برای مثال، اگر سایدبار شما حاوی لینکها و کلمات کلیدی نامرتبط باشد، موتور جستجو ممکن است تصویر نادرستی از موضوع مقاله به دست آورد. به همین دلیل، سیستمهای ایندکسگذاری با کاهش وزن یا حذف این بخشها، تمرکز خود را بر متون اختصاصی صفحه میگذارند.
۲. مدیریت و توزیع اعتبار لینکها (Link Equity)
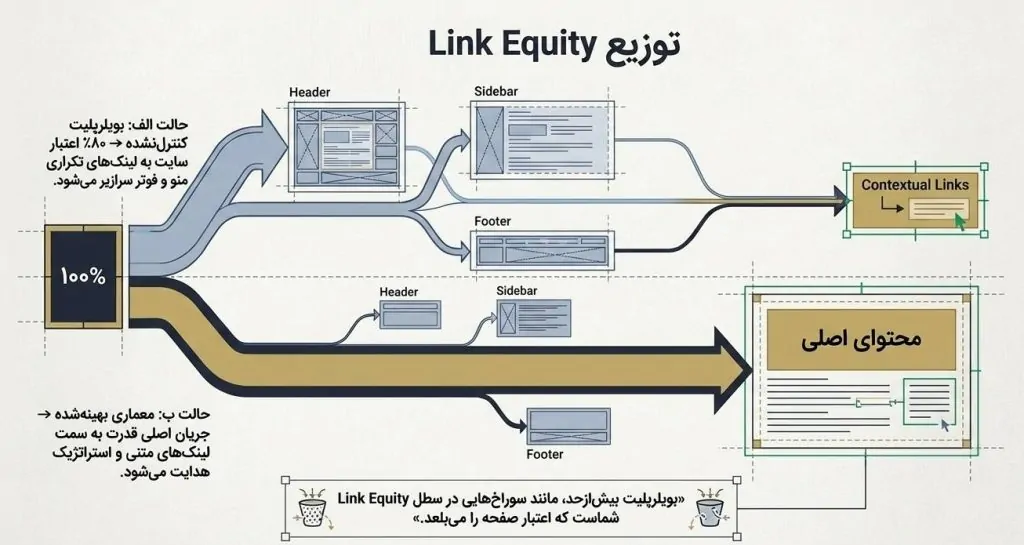
لینکهایی که در بخشهای تکراری مانند سایدبار یا فوتر قرار دارند و در تمام صفحات سایت تکرار میشوند، لینکهای ناوبری سراسری (Sitewide) نامیده میشوند. الگوریتمهای ارزیابی گوگل برای این لینکها وزن و اعتبار کمتری در انتقال مفهوم موضوعی نسبت به لینکهای موجود در متن اصلی مقاله قائل میشوند.
۳. بهبود چکیدهها و پیشنهادهای جستجو
موتورهای جستجو برای ساخت چکیده صفحه (Snippet) در نتایج و ارائه پیشنهادهای مرتبط به کاربران، نیاز به استخراج متن اصلی دارند. تفکیک متون تکراری مانع از آن میشود که کلمات ناوبری مانند «ورود به حساب» یا «درباره ما» به عنوان چکیده در نتایج گوگل ظاهر شوند.
۴. بهینه سازی خزش و تحلیل ساختار صفحه
تحلیل درخت ساختار صفحه (DOM Tree) به موتورهای جستجو کمک میکند تا بدون نیاز به خزش بیرویه، بخشهای اصلی را از بخشهای قالبی جدا کنند. این کار سرعت پردازش صفحات را افزایش داده و روند ارزیابی سایت را بهینهتر میکند.
۵. جلوگیری از خطای محتوای تکراری داخلی
زمانی که درصد زیادی از صفحات مختلف یک وبسایت را منوها، فرمها و متون حقوقی یکسان تشکیل دهند، ممکن است موتور جستجو این صفحات را بیش از حد مشابه تشخیص دهد. کاهش وزن بخشهای تکراری باعث میشود محتوای منحصربهفرد هر صفحه برجسته شده و ارزش واقعی آن دیده شود.
گوگل چگونه Boilerplate را تشخیص میدهد؟
اینجا به بخش اصلی و فنیترین قسمت مقاله میرسیم: گوگل دقیقا از چه سیگنالهایی برای شناسایی بخشهای تکراری و قالبی (Boilerplate) استفاده میکند؟
موتور جستجو برای جداسازی محتوای اصلی از بخشهای قالبی، ترکیبی از سیگنالهای ساختاری، بصری و متنی را به کار میگیرد. مهمترین روشهای تشخیص عبارتاند از:
۱. تحلیل ساختار درختی DOM و تگهای معنایی
صفحه وب توسط موتور جستجو به صورت یک درخت از عناصر (DOM Tree) دیده میشود. استفاده از تگهای معنایی HTML5 مانند nav، aside و footer یا الگوهای رایج در نام کلاسها و شناسهها (مانند sidebar، widget، menu و footer) سیگنال مستقیمی برای طبقه بندی یک بخش به عنوان Boilerplate است. علاوه بر این، موقعیت یک بلوک در ساختار درختی صفحه، مثلا قرارگیری عنصر در پایینترین بخشهای درخت یا فرزند مستقیم بدنه بودن، به تشخیص فوتر و منوها کمک میکند.
۲. ویژگیهای هندسی و ابعاد بصری بلوکها
گوگل علاوه بر کدها، ابعاد و ظاهر فیزیکی بلوکها را در قالب درخت DOM بررسی میکند. به عنوان مثال، بلوکهایی که نسبت طول به عرض غیرمعمول دارند (مانند نوارهای بسیار باریک و بلند با نسبت بیش از ۳ به ۱)، بلوکهای کوچکی که مساحت کمتری دارند، یا لیستهایی که لینکهای آنها از یک سمت کاملا تراز شدهاند، ویژگیهای هندسی مشخصی از بخشهای ناوبری و سایدبار را نشان میدهند.
۳. نسبت تراکم لینک به متن (Link Density)
یکی از قویترین سیگنالها، نسبت طول متن داخل لینکها به کل متن یک بلوک است. اگر بخش عمده متن یک بخش (مثلا بیش از ۸۰ درصد آن) درون تگهای لینک قرار داشته باشد، این بخش به احتمال بسیار زیاد یک منوی ناوبری یا لیست لینک است، نه محتوای اصلی. پاراگرافهای محتوایی معمولی معمولا متن زیاد و لینک کم دارند، درست برعکس سایدبارها و منوها.
۴. مقایسه الگوی ساختار در صفحات متعدد (Template Detection)
مهمترین سیگنال در سمت سرور، مقایسه ساختار DOM چند صفحه از یک سایت با یکدیگر است. الگوریتمهای استخراج قالب با بررسی اینکه کدام بخشها با ساختار و کلمات یکسان یا تقریبا یکسان در صفحات مختلف یک سایت تکرار میشوند، آن بخشها را به عنوان قالب سایت جدا میکنند.
۵. تحلیل مقصد لینکها و آدرسها
گوگل علاوه بر ظاهر لینک، به آدرس مقصد آن نیز توجه میکند. لینکهایی که به صفحه اصلی سایت، یا صفحاتی مثل «تماس با ما»، «حریم خصوصی»، «قوانین» یا «راهنما» اشاره دارند، معمولا به عنوان لینکهای ناوبری شناخته میشوند. همچنین در بلوکهای تبلیغاتی، ارجاع اکثر لینکها به خارج از دامنه اصلی سایت، سیگنالی برای شناسایی تبلیغات است.
۶. بررسی کدهای جاوااسکریپت و رویدادها
عناصر ناوبری و تعاملی معمولا با کدهای جاوااسکریپت کنترل میشوند. وجود کدهای جاوااسکریپت و ویژگیهای رویدادی (مانند onclick یا onmouseover) در یک عنصر یا عناصر والد آن، نشان میدهد که آن بخش احتمالا بخشی از ابزارهای تعاملی یا قالب سایت است، نه متن اصلی مقاله.
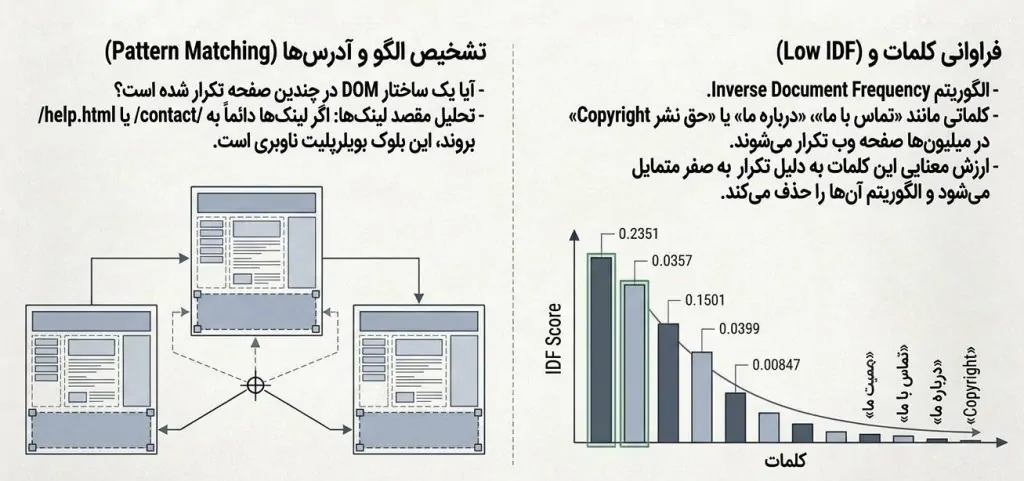
۷. فهرست کلمات کلیدی قالبی و سنجش فراوانی (Low IDF)
استفاده از لیست پیشفرض کلمات عمومی (مانند خانه، راهنما، شرایط استفاده، کپیرایت) و همچنین بررسی کلماتی که در سطح وب فراوانی بسیار بالایی دارند اما ارزش اطلاعاتی کمی تولید میکنند، به سیستم کمک میکند تا بخشهای عمومی را سریعتر شناسایی کند.
۸. محاسبه امتیاز احتمال و کاهش وزن در ایندکس
در نهایت، سیستم برای هر بلوک یک امتیاز احتمال (Likelihood Score) محاسبه میکند. هرچه یک بلوک سیگنالهای بیشتری از بخشهای قالبی داشته باشد، این امتیاز بالاتر میرود. با عبور امتیاز از حد مشخص، آن بخش از فرایند استخراج کلمات کلیدی و رتبهبندی محتوای اصلی حذف شده یا وزن بسیار کمتری دریافت میکند.
تفاوت بین دنبالکردن لینک (Crawling) و ارزشدهی به آن (Ranking)
نکتهای که اغلب اشتباه فهمیده میشود این است که تشخیص Boilerplate به این معنا نیست که گوگل لینکهای آن بخش را دنبال نمیکند. گوگل معمولا همه لینکهای قابل خزش صفحه را دنبال میکند تا صفحات جدید را کشف کند، فارغ از اینکه لینک در سایدبار باشد یا محتوای اصلی. آنچه واقعا تغییر میکند، اعتباری است که آن لینک به عنوان یک رأی یا سیگنال ربط موضوعی منتقل میکند. یک لینک تک باره که در دل متن یک مقاله و توسط نویسنده قرار گرفته، معمولا وزن بیشتری نسبت به همان لینک وقتی که در سایدبار صدها صفحه دیگر تکرار شده، دریافت میکند.
چطور Boilerplate میتواند به سئوی سایت شما آسیب بزند؟
اگر بخش زیادی از یک صفحه را محتوای تکراری (منو، سایدبار، تبلیغات) تشکیل دهد و نسبت محتوای اصلی و منحصر به فرد صفحه پایین باشد، چند اثر منفی ممکن است رخ دهد:
- خطا در تشخیص موضوع اصلی: گوگل ممکن است به سختی بتواند موضوع اصلی و منحصر به فرد صفحه را از میان محتوای تکراری تشخیص دهد.
- کاهش اعتبار لینکهای استراتژیک: اگر لینکهای مهم سایت شما فقط در بخشهای تکراری (مثل سایدبار) قرار گرفته باشند، آن لینکها اعتبار کمتری نسبت به قرارگیری در متن اصلی دریافت میکنند.
- افت کیفیت کلی صفحه: حجم بالای محتوای تکراری بین صفحات، نسبت محتوای منحصر به فرد به کل صفحه را کاهش میدهد که در ارزیابی کیفیت صفحه اثر منفی دارد.
راهکارهای عملی برای کاهش اثر منفی بویلر پلیت
قرار دادن لینکهای مهم در متن اصلی، نه سایدبار
قرار دادن لینکهای مهم در متن اصلی، نه سایدبار: اگر لینکی برایتان استراتژیک است (مثلا لینک به یک صفحه محصول یا خدمت مهم)، آن را در دل محتوای اصلی و مرتبط با موضوع مقاله قرار دهید، نه صرفا در سایدبار یا منوی ناوبری. لینکهای داخل متن، اعتبار و ربط موضوعی بیشتری نسبت به لینکهای تکراری قالب منتقل میکنند.
استفاده صحیح از تگهای سمانتیک HTML5
استفاده صحیح از تگهای معنایی HTML5: استفاده درست از تگهای nav، aside، footer، main و article به موتور جستجو کمک میکند تا سریعتر و دقیقتر بین محتوای اصلی و بخشهای قالبی تفکیک قائل شود. این تفکیک واضح باعث میشود گوگل کمتر دچار خطا در تشخیص موضوع اصلی صفحه شود.
پرهیز از تکرار بیرویه بلوکهای یکسان در همه صفحات
پرهیز از تکرار بیرویه بلوکهای یکسان در همه صفحات: سعی کنید بخشهای سایدبار یا ویجتهای فرعی صفحه را تا حد امکان مرتبط با محتوای همان صفحه سفارشیسازی کنید، به جای اینکه دقیقا یک بلوک ثابت را در تمام صفحات سایت بدون تغییر تکرار کنید. این کار به کاهش حجم محتوای کاملا تکراری بین صفحات کمک میکند.
سؤالات متداول
موتورهای جستجو چگونه بدون نیاز به مقایسه صفحات مختلف یک سایت، بخشهای هدر و فوتر را تفکیک میکنند؟
الگوریتمها میتوانند تنها با پردازش ساختار محلی کد یک صفحه (Single DOM Tree)، قالببندی کلی را شناسایی کنند. آنها شاخصهای هندسی مانند تراز بودن لینکها، ابعاد کادر، تگهای والد (مانند بدنه اصلی body) و ویژگیهای استایل را بررسی کرده و بدون خزش موازیِ کل صفحات سایت، بویلرپلیتها را تشخیص میدهند.
آیا کلیک کاربران بر روی بخشهای تکراری، ارزیابی موتور جستجو از Boilerplate بودن آن بخش را تغییر میدهد؟
بله؛ سیستمهای جستجو با ثبت دادههای تعاملی و نرخ کلیک (Click-Through)، سیگنالهای دریافتی را بهینهسازی میکنند. اگر لینکی در بخشهای قالبی قرار بگیرد اما کاربران تمایلی به کلیک بر روی آن نشان ندهند، سیستم ارزش محتوایی آن بخش را در تحلیلهای بعدی کاهش داده یا کلمات کلیدی آن را کموزن میکند.
آیا تکرار مداوم اطلاعیه کپیرایت و پیوندهای فوتر در تمام صفحات، موجب جریمه محتوای تکراری (Duplicate Content) میشود؟
خیر، به هیچ وجه جریمهای برای این کار در نظر گرفته نمیشود. موتورهای جستجو مجهز به الگوریتمهای اختصاصی برای شناسایی محتوای قالبی (Boilerplate Detection) هستند که به صورت هوشمند بخشهای تکراری و غیرضروری را از بدنه اصلی متمایز میکنند. نمایهساز (Indexer) موتور جستجو با بررسی فاکتورهایی مانند تکرار یک متن در صفحات متعدد (مانند عبارت Copyright)، موقعیت هندسی آن در پایینترین بخش صفحه و داشتن تگ والد بدنه اصلی (body) در ساختار کدها، متوجه میشود که این بخش ارتباطی با موضوع اصلی صفحه ندارد. در نتیجه، هنگام رتبهبندی، وزن و اعتبار این بخشهای تکراری را به شدت کاهش داده یا کاملاً فیلتر میکند تا تمرکز اصلی بر روی متن اختصاصی صفحه شما باشد.